
Andrej Karpathy
@karpathy · 15 ago 2023
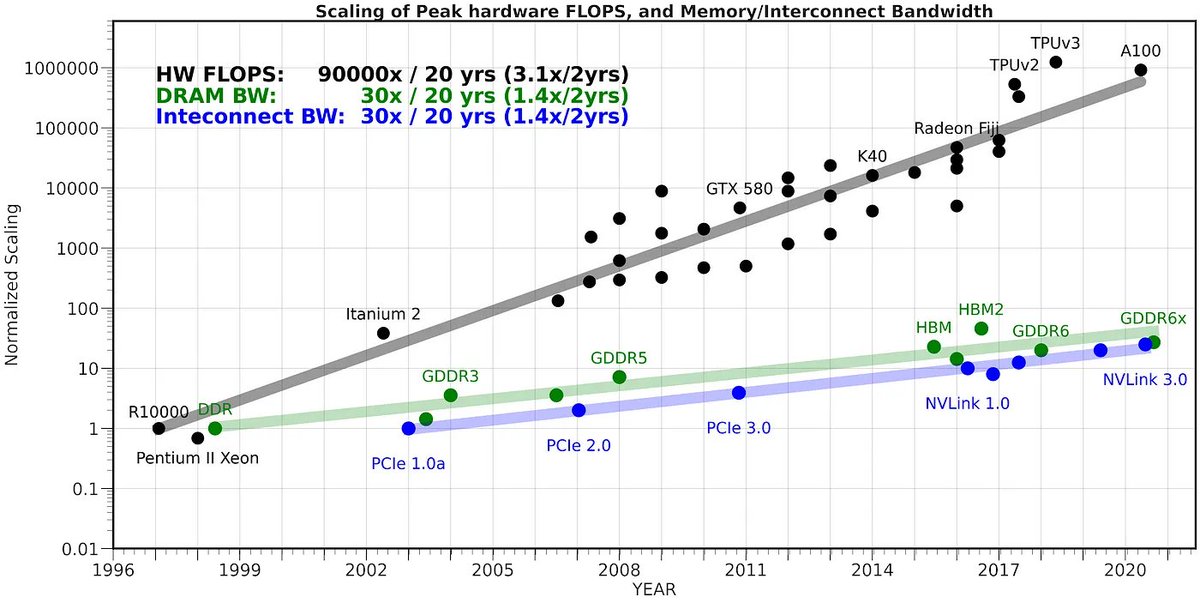
"How is LLaMa.cpp possible?"
great post by @finbarrtimbers
llama.cpp surprised many people (myself included) with how quickly you can run large LLMs on small computers, e.g. 7B runs @ ~16 tok/s on a MacBook. Wait don't you need supercomputers to work
Elon Musk
@elonmusk
A100s already seem so quaint
04:16 · 16 de agosto de 2023 · 79,5 mil visualizaciones
52
27
793